
관리자 › 평가 › 아레나 · 리더보드
아레나 (Arena)
모델명을 감춘 채 응답을 받게 해, 어떤 모델인지 모르는 상태에서 평가하도록 하는 기능입니다.설정
관리자 › 평가 › 아레나
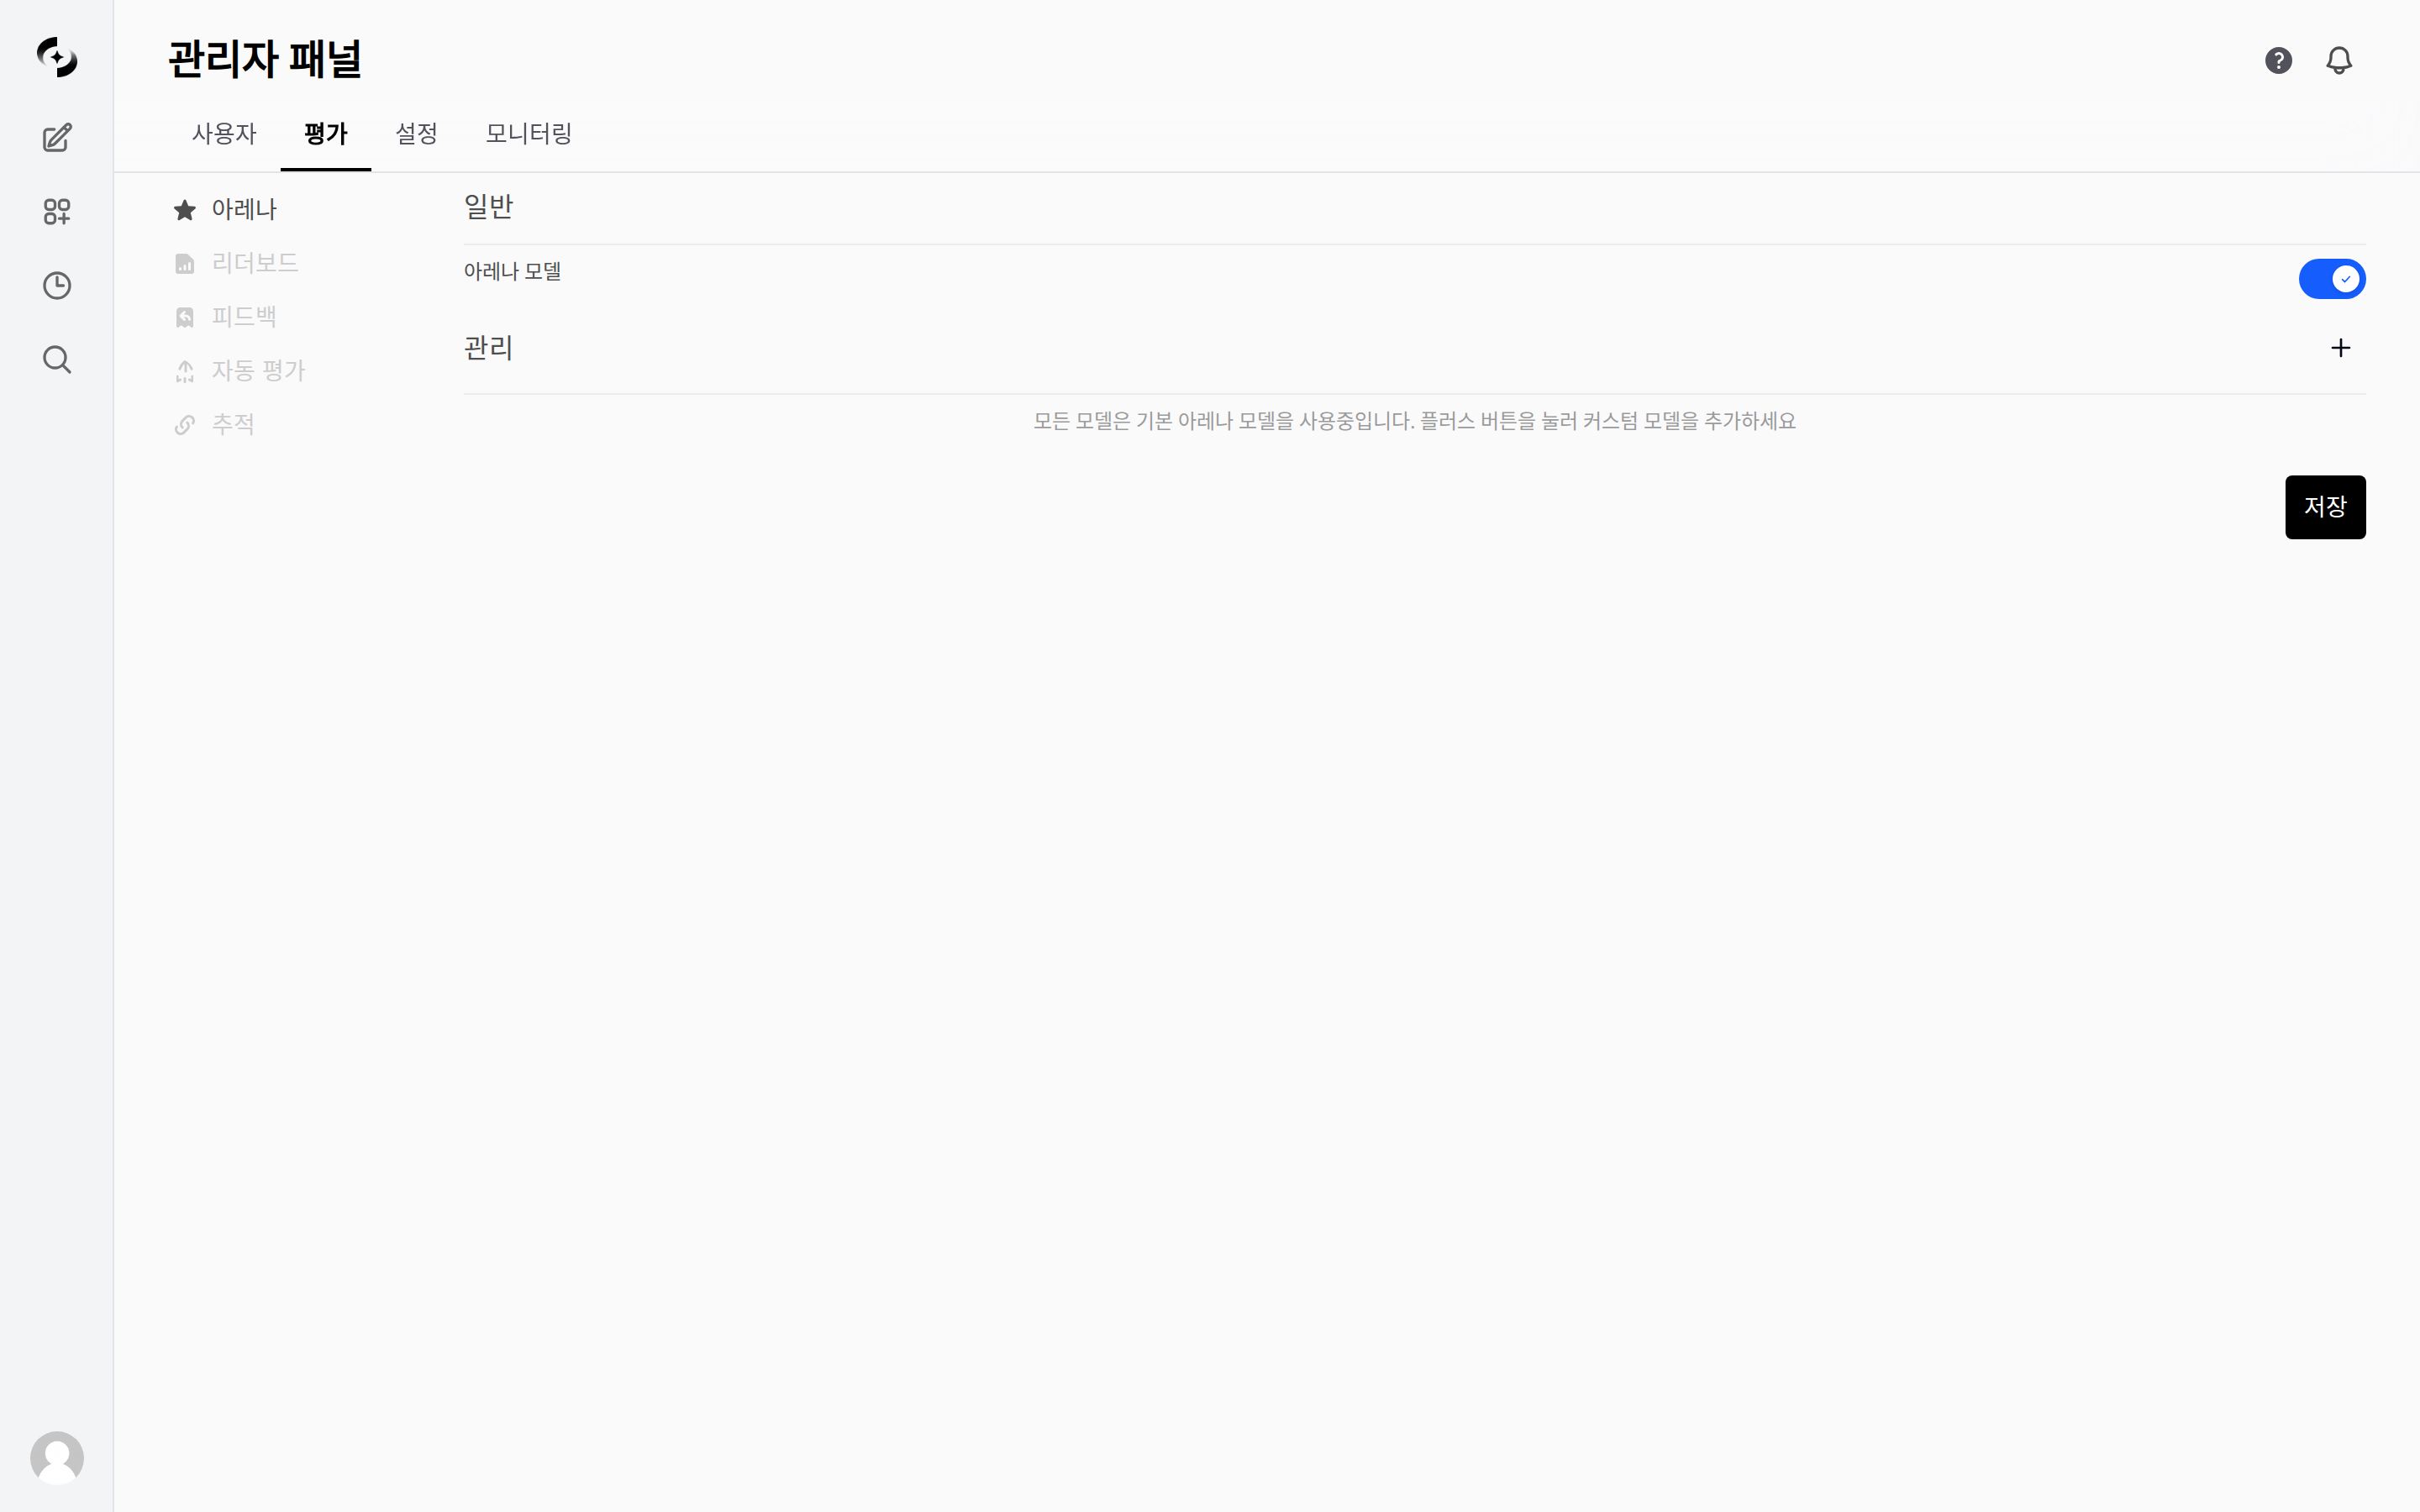
관리자 > 평가 > 아레나 — 아레나 모델 토글 및 비교 모델 관리
아레나 모델 토글을 끄면 아래 관리 영역이 화면에서 사라집니다. 토글 변경은 화면 오른쪽 아래 저장을 눌러야 반영되며, 저장되면 “설정이 성공적으로 저장되었습니다” 알림이 표시됩니다. 반면 커스텀 모델의 추가·편집·삭제는 누르는 즉시 저장됩니다.
아레나 평가를 수집하려면 관리자 › 설정 › 일반의 기능 토글 › 메시지 평가 활성화가 켜져 있어야 합니다(기본값 켜짐). 꺼져 있으면 응답에 좋아요·싫어요 버튼 자체가 표시되지 않아, 아레나를 켜도 리더보드에 데이터가 쌓이지 않습니다.
관리 항목의 + 로 비교 대상 모델을 직접 추가합니다.
- 이름·ID는 필수이며, 접근 권한과 후보로 쓸 모델을 지정합니다. 이름을 입력하면 ID가 자동으로 채워집니다.
- 모델 항목 오른쪽의 포함 / 미포함 라벨을 누르면 모드가 바뀝니다. 포함이면 선택한 모델만 후보가 되고, 미포함이면 선택한 모델을 뺀 나머지 전체가 후보가 됩니다. 모델을 하나도 선택하지 않으면 이 설정과 관계없이 전체 모델이 후보입니다.
- 등록한 모델은 목록 행 오른쪽의 구성(톱니) 버튼으로 편집하고, 편집 창의 삭제 버튼으로 확인 절차를 거쳐 제거합니다. 편집 중에는 ID를 바꿀 수 없습니다.
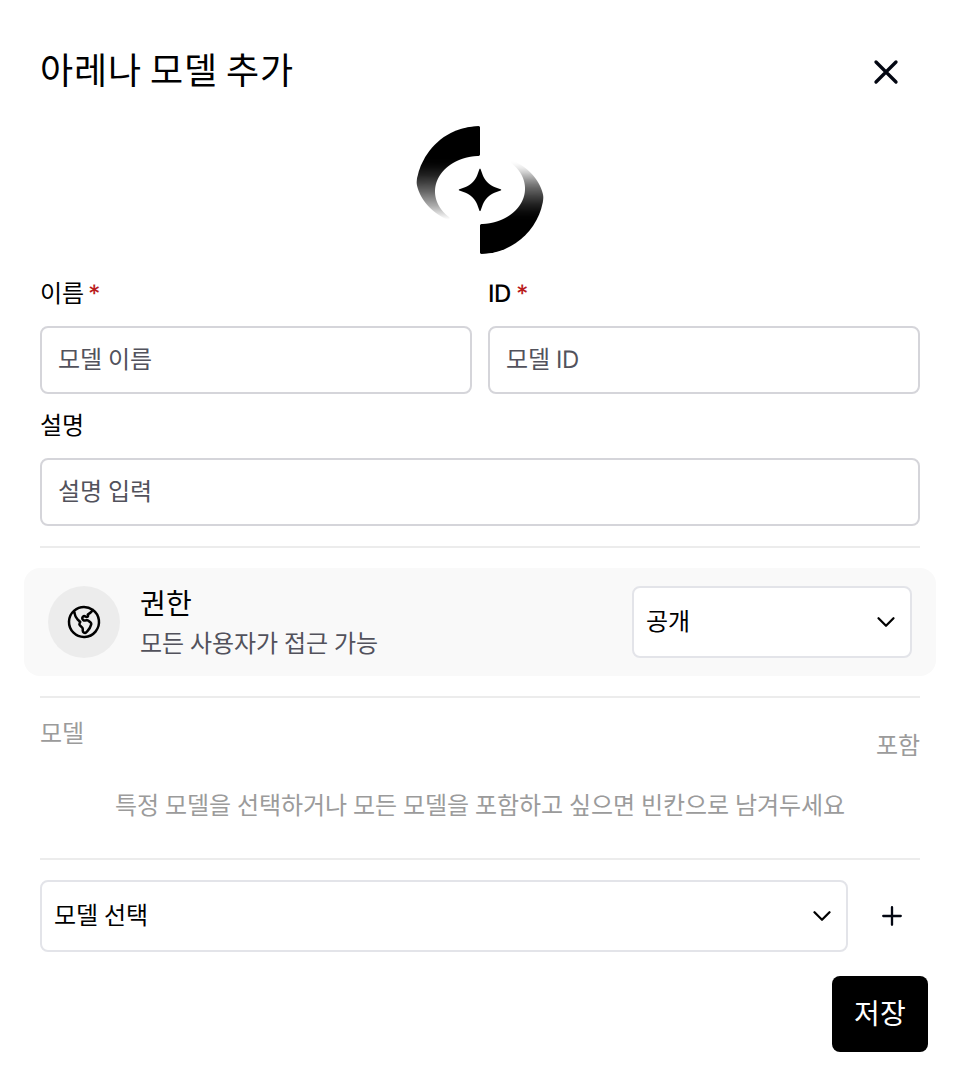
관리자 > 평가 > 아레나 > 관리 > + — 아레나 비교 모델 커스텀 추가 모달
Arena Model). 사용자가 이 모델로 질문하면 시스템이 후보 모델 중 하나를 무작위로 골라 응답 1개를 생성하며, 실제 모델명은 감춰집니다.
- 응답을 나란히 놓고 비교하려면 사용자가 채팅 화면 위쪽 모델 선택기에서 모델을 2개 이상(최대 4개) 직접 골라야 합니다. 아레나 모델을 여러 칸에 지정하면 양쪽 모두 익명인 상태로 비교할 수 있습니다.
- 평가는 “더 나은 응답 고르기” 버튼이 아니라 각 응답의 좋아요·싫어요로 남깁니다. 의견을 적는 창이 열리면 “(모델명)이 생성한 응답입니다” 문구로 실제 모델이 공개됩니다.
리더보드 (Leaderboard)
관리자 › 평가 › 리더보드
- 한 질문에 응답이 2개 이상 있는 상태에서 받은 좋아요·싫어요만 계산에 들어갑니다 — 모델을 여러 개 선택해 받은 응답, 같은 질문을 재생성해 받은 응답이 모두 해당합니다.
- 좋아요는 그 응답이 나머지 응답을 이긴 것으로, 싫어요는 진 것으로 처리해 Elo 점수를 갱신합니다. 반대로 아레나 모델로 받은 응답이라도 비교할 다른 응답이 없으면 리더보드에 반영되지 않습니다.
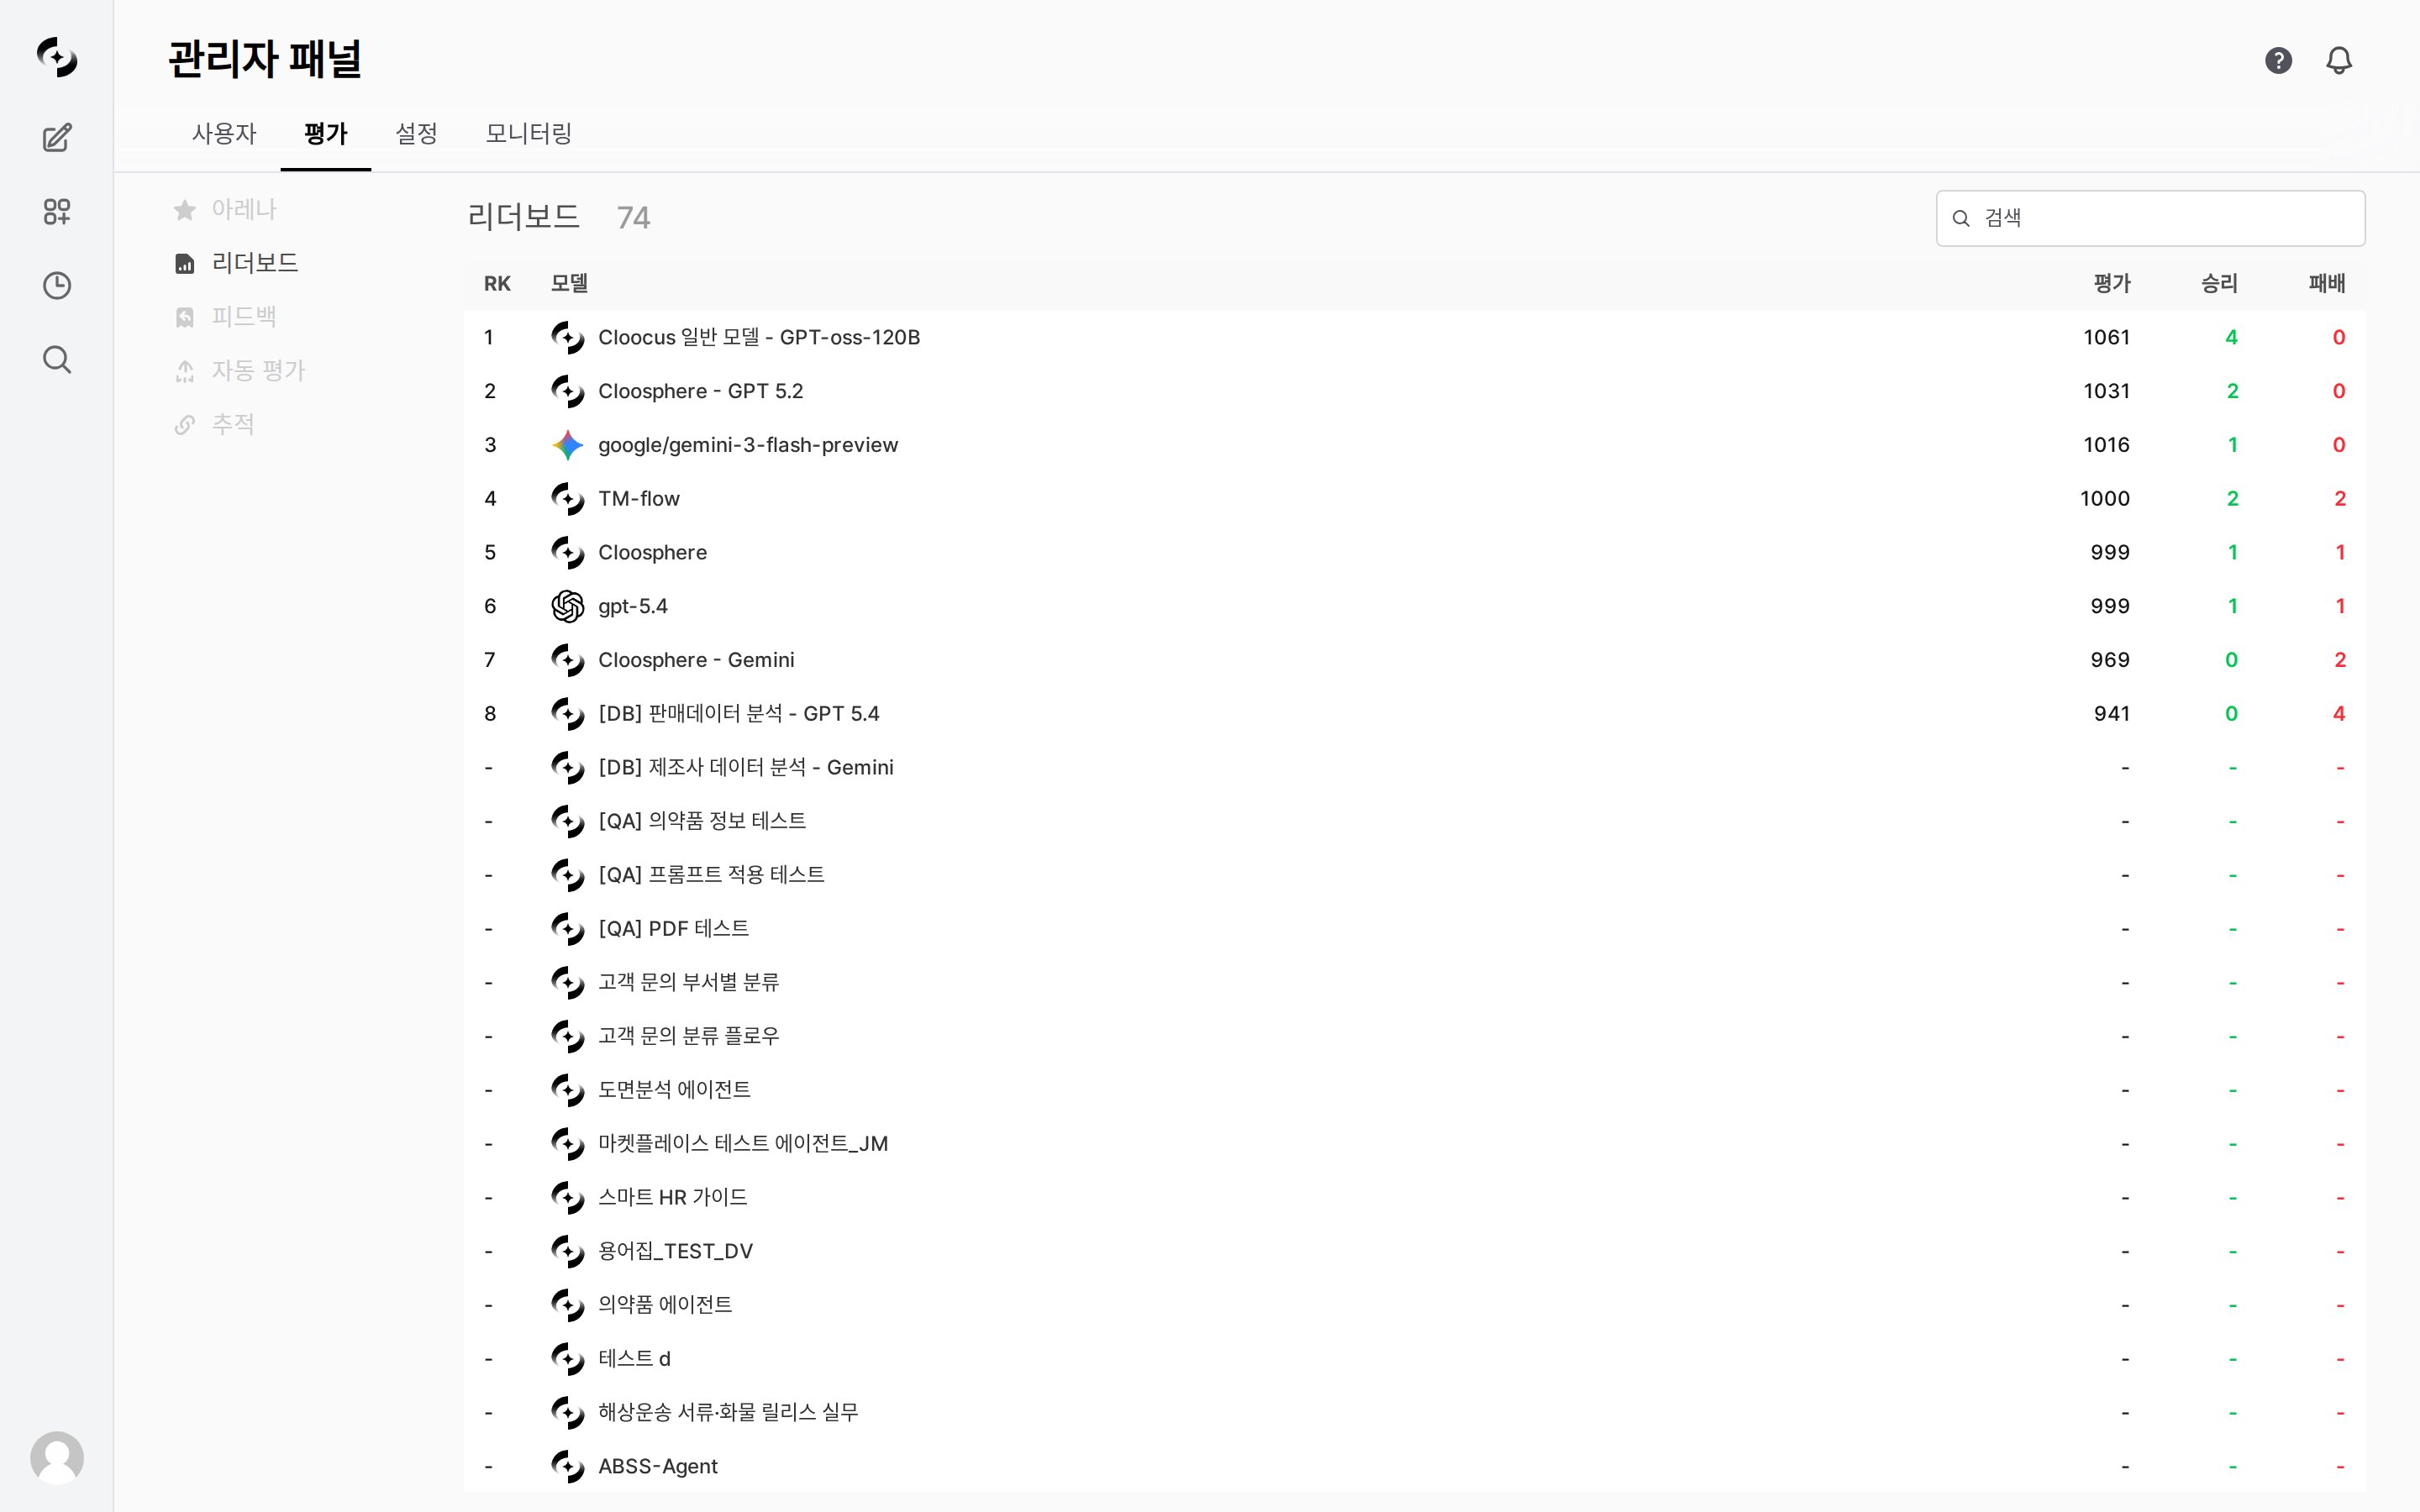
관리자 > 평가 > 리더보드 — Elo rating 기반 모델 순위 테이블
- 검색창을 처음 누르면 브라우저가 의미 비교용 임베딩 모델을 내려받아 준비하고, 입력을 멈춘 뒤 약 1.5초 후 재계산이 시작됩니다. 계산 중에는 표가 흐려지며 로딩 표시가 나타나므로 첫 검색은 결과가 늦게 나올 수 있습니다.
- 재정렬은 피드백에 달린 태그와의 의미 유사도로 계산합니다. 태그가 없는 피드백은 반영되지 않아, 태그가 거의 없는 환경에서 검색하면 평가 점수가 모두 1000으로 같아집니다.
- 임베딩 모델은 외부에서 내려받으므로 인터넷이 차단된 환경에서는 이 검색이 동작하지 않을 수 있습니다.
예시: RK 1 · Cloocus 일반 모델 - GPT-oss-120B · 평가 1061 · 승리 4 · 패배 0
리더보드에는 평가 이력이 있는 모델만이 아니라 접근 가능한 모델이 모두 나열됩니다(아레나 모델 자체와 숨김 처리된 모델은 제외). 아직 평가 이력이 없는 모델은 RK·평가·승리·패배가 모두
- 로 표시되고 목록 맨 아래에 이름순으로 정렬됩니다. 제목 옆 숫자도 평가된 모델 수가 아니라 나열된 전체 모델 수입니다.
행에 마우스를 올리면 승리·패배 숫자가 승률·패률(%)로 바뀝니다(분모는 승리+패배 합계). 이 숫자는 피드백 건수가 아니라 상대 모델별 대결 수입니다 — 한 질문에 응답이 4개일 때 그중 하나에 좋아요를 한 번 누르면 승리가 3 오르고, 나머지 세 응답의 패배가 각각 1 오릅니다.
리더보드는 베타테스트 중이며, 평가 기준이 알고리즘 수정과 함께 변할 수 있습니다. Elo 평가 시스템을 기반으로 실시간 업데이트됩니다.
활용 사례
모델 간 품질 비교
모델 간 품질 비교
- 아레나 모델을 켜고, 사용자가 한 질문에 여러 응답을 받아 좋아요·싫어요를 남기도록 안내합니다
- 자동 평가의 모델별 통계에서 평균 점수를 비교합니다
- 비용 대비 품질 효율이 높은 모델을 기본 모델로 설정합니다
관련 페이지
평가
평가 방식 전체 개요와 길잡이
자동 평가
심판 LLM 기반 자동 품질 채점
사용량
모델별 토큰 사용량 확인